Cosa significa DCI
 Sep 15, 2025|
Nel panorama digitale contemporaneo, i data center sono diventati la spina dorsale dell'infrastruttura del cloud computing, elaborando enormi volumi di dati consumando consumi notevoli quantità di energia.
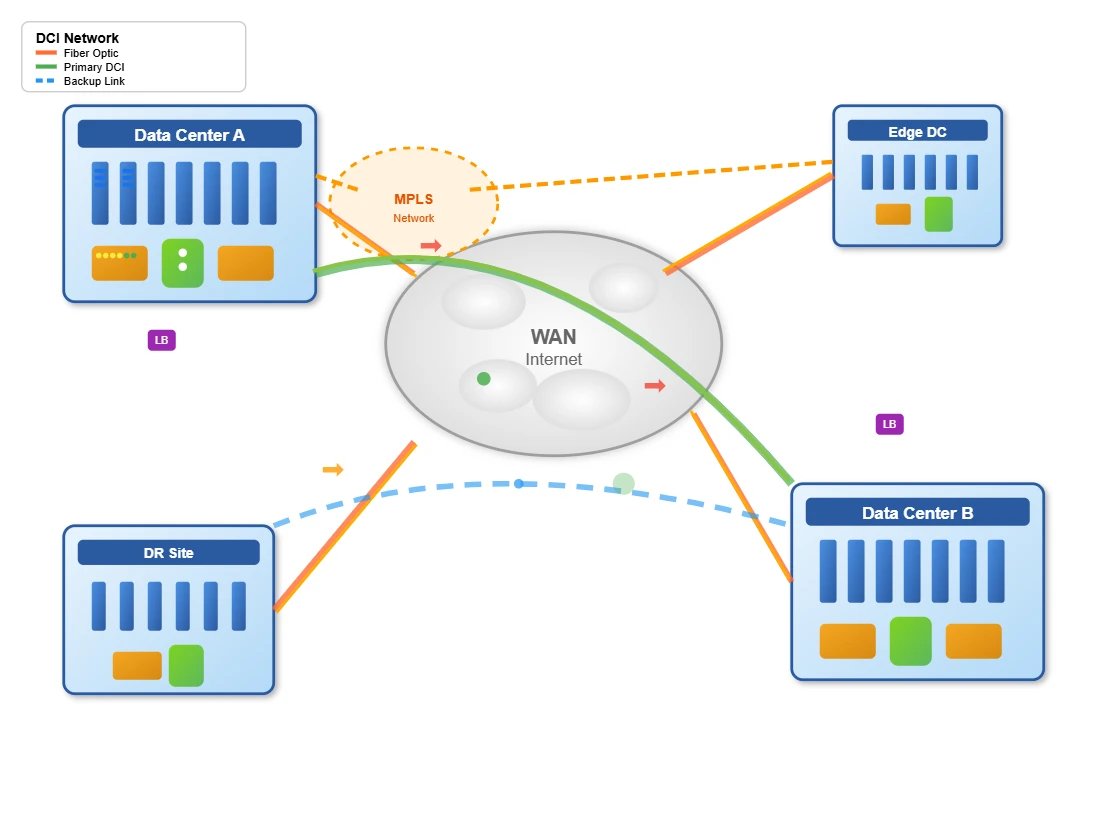
La domanda "Cosa significa DCI" sorge spesso nelle discussioni sulle moderne architetture dei data center, in cui DCI rappresenta InterConnect Data Center, la tecnologia che collega più data center per consentire la condivisione delle risorse e la distribuzione del carico di lavoro.
Energia - La pianificazione efficiente è emersa come una sfida fondamentale, che richiede approcci sofisticati per bilanciare i requisiti delle prestazioni con l'ottimizzazione del consumo di energia. La metodologia di pianificazione della rete del data center (DENS) rappresenta un progresso significativo nell'affrontare queste sfide attraverso la modellazione gerarchica e le strategie di allocazione delle risorse intelligenti.

Concetti chiave nel networking dei data center
Data Center Interconnect (DCI)
Tecnologia che collega più data center per consentire la condivisione delle risorse, la distribuzione del carico di lavoro e il ripristino di emergenza tra strutture geograficamente disperse.

Congestione della rete
Si verifica quando il traffico di rete supera la capacità, spesso causata da limitazioni del cuscinetto nelle infrastrutture Ethernet e non corrispondenze di larghezza di banda tra i collegamenti.

Metodologia delle tane
Un approccio gerarchico alla pianificazione dei data center che ottimizza l'efficienza energetica mantenendo le prestazioni attraverso un'allocazione intelligente delle risorse.
Congestione della rete in ambienti di data center
La sfida di Ethernet - Infrastruttura basata su
I moderni data center abbracciano la filosofia dell'utilizzo dei media Ethernet per trasportare vari tipi di traffico, tra cui le comunicazioni LAN, SAN e IPC. Mentre la tecnologia Ethernet offre maturità, facilità di distribuzione e gestione relativamente semplice, presenta sfide significative in termini di limitazioni delle prestazioni hardware, in particolare nella capacità del buffer.
Le dimensioni tipiche del tampone Ethernet funzionano a livello di magnitudo 100 kb, mentre i router Internet presentano in genere dimensioni del tampone di magnitudo 100 MB. Questa sostanziale differenza di 1000X nella capacità del buffer, combinata con modelli di traffico di larghezza di banda - elevati, costituisce la causa principale della congestione della rete in ambienti di data center.
Confronto della capacità tampone
Ethernet switch 100 kb
Router Internet 100 MB
La differenza di 1000x nella capacità del buffer crea sfide significative per la gestione di modelli di traffico a larghezza di banda - in alto nei data center.
Manifestazione di congestione negli switch del data center
La manifestazione della congestione negli switch del data center può verificarsi in più direzioni. Nella direzione del downlink, la congestione emerge quando la capacità aggregata dei collegamenti di ingresso supera la capacità dei collegamenti in uscita. Per le direzioni di uplink, la mancata corrispondenza della larghezza di banda è determinata principalmente dal rapporto di convergenza della larghezza di banda, con la congestione che si verifica quando la larghezza di banda aggregata di tutte le porte del server supera la capacità di uplink totale dell'interruttore.
Questi punti di congestione, spesso indicati come hotspot, possono influire fortemente sulla capacità della rete del data center di trasmettere i dati in modo efficiente, riducendo potenzialmente il rendimento fino al 70% in casi estremi.
Congestione del downlink
Si verifica quando il traffico totale in arrivo supera la capacità in uscita di una porta di switch, creando bottiglia nel flusso di dati dai livelli di rete più alti a quelli più bassi.
Congestione di uplink
Si verifica quando il traffico di server aggregato supera la capacità di uplink, in genere determinato dal rapporto di convergenza della larghezza di banda della progettazione della rete.
Standard IEEE 802.1qau e gestione della congestione
Come funziona 802.1qau
Gli interruttori sovraccarichi rilevano la congestione e generano segnali di notifica
I segnali di congestione vengono propagati all'invio di dispositivi
I mittenti accelerano le loro velocità di trasmissione per ridurre la congestione
L'utilizzo della rete è mantenuto ad alti livelli (fino al 95%)
La perdita di pacchetti è ridotta al minimo attraverso il controllo della velocità proattiva
Il gruppo di task Bridging Data Center (IEEE 802.1) ha sviluppato soluzioni di controllo della congestione di livello 2, in particolare le specifiche IEEE 802.1QAU. Questo standard introduce i loop di feedback per la notifica di congestione tra gli switch del data center, consentendo a switch sovraccarichi di utilizzare i segnali di notifica di congestione per accelerare i mittenti di carico -.
Sebbene questa tecnica impedisca effettivamente la perdita di pacchetti a causa della congestione e mantiene elevati tassi di utilizzo della rete fino al 95%, non risolve fondamentalmente il problema sottostante.
"Un approccio più efficiente prevede la distribuzione strategica dei dati - compiti intensivi per evitare di condividere percorsi comuni di comunicazione. Ad esempio, per sfruttare appieno le caratteristiche di isolamento spaziale di tre- architetture di livello, dati - Le attività intensive devono essere distribuite proporzionalmente attraverso i server di informazione in base al calcolo in base alle loro esigenze di comunicazione."
Questi dati - compiti intensivi, simili alle applicazioni di condivisione di video -, generano flussi di bit costanti agli utenti finali comunicando contemporaneamente con altri lavori in esecuzione all'interno del data center. Tuttavia, questo metodo di distribuzione distribuito proporzionalmente contraddice l'energia - Obiettivi di pianificazione efficienti, che mirano a utilizzare set di server minimi e set di risorse di comunicazione per gestire tutti i carichi di lavoro.
Il framework della metodologia delle tane
Approccio di modellazione gerarchica
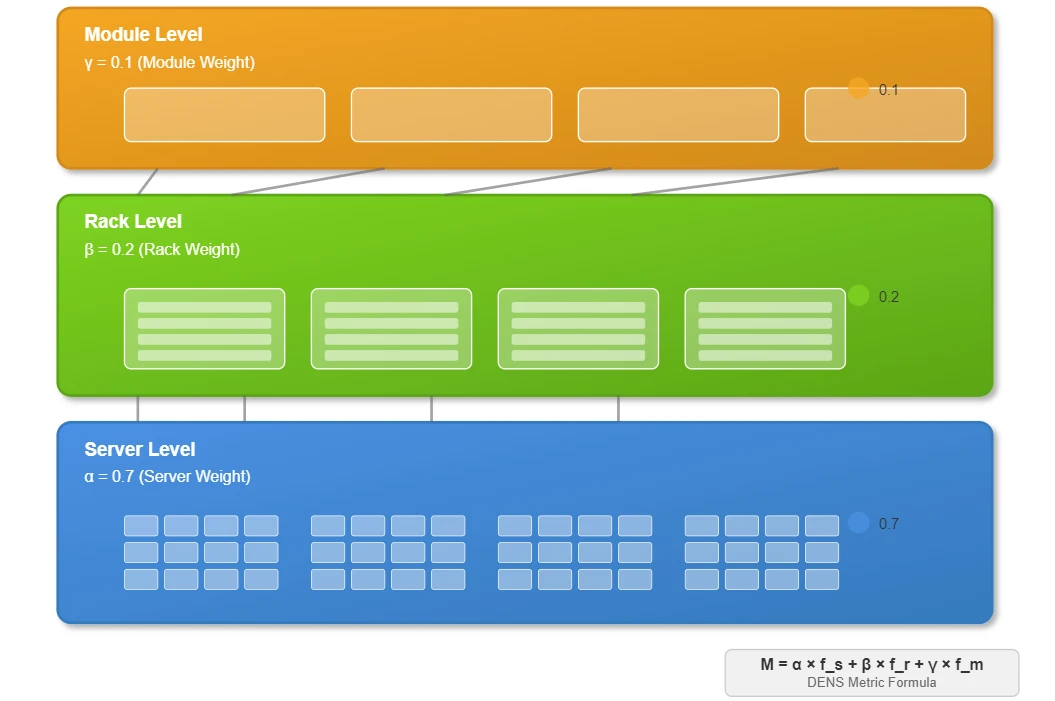
La metodologia delle tane rappresenta un passaggio di paradigma dagli approcci tradizionali che modellano i data center come pool omogenei di risorse di calcolo del server. Invece, la tasca propone un modello gerarchico coerente con le topologie del data center tradizionali.
Per tre data center di livello -, la metrica m è definita come una combinazione ponderata del server - funzione di livello F_S, rack - Funzione di livello F_R e modulo - Funzione di livello F_M:
M = × f_s + × f_r + × f_m
Dove, e rappresentano i coefficienti di ponderazione che determinano come i componenti corrispondenti (server, rack, moduli) influenzano le metriche di valutazione.
Coefficienti di ponderazione
(Server - peso di livello) in genere 0,7
Favori che selezionano i server di caricamento -- all'interno di rack leggermente carichi
(Rack - peso di livello) in genere 0,2
Dai la priorità ai rack di calcolo con carichi di rete bassi
(Modulo - Peso di livello) in genere 0,1
Favorisce la selezione di moduli leggermente caricati, cruciali per il consolidamento delle attività
Carico del server e potenziale di comunicazione
La combinazione di caricamento del server L_S (L) e il suo potenziale di comunicazione Q_S (Q) costituiscono la base primaria per la selezione del server. Questa relazione è espressa attraverso:
f_s(l,q) = L_s(l) × (Q_s(q)^φ)/δ_t
L_s(l)
Dipende dal carico di Server L, calcolato utilizzando una funzione sigmoidea specializzata
Q_s(q)
Definisce il carico sugli uplink di rack analizzando le condizioni di congestione nella coda di uscita di switch q
δ_t
Larghezza di banda su - fattore di provisioning in top - di - switch rack (tor)
φ
Coefficiente Definizione del rapporto tra L_S (L) e Q_S (Q) nella metrica
Definizione e ottimizzazione del fattore di carico
Il fattore di carico delle tane è definito come la somma di due funzioni sigmoidi per affrontare la sfida che i server inattivi consumano circa il 67% del loro consumo di energia di picco:
L_s(l) = 1/(1 + e^(-10(l - 0.5))) - 1/(1 + e^(-2(l - (1 - ε/2))))
Il primo componente definisce la forma del sigmoide primario, mentre il secondo funge da funzione di penalità progettata per convergere i valori di carico massimo del server. Il parametro ε definisce l'intervallo e la pendenza della porzione in declino della curva.
Curva di ottimizzazione del carico del server
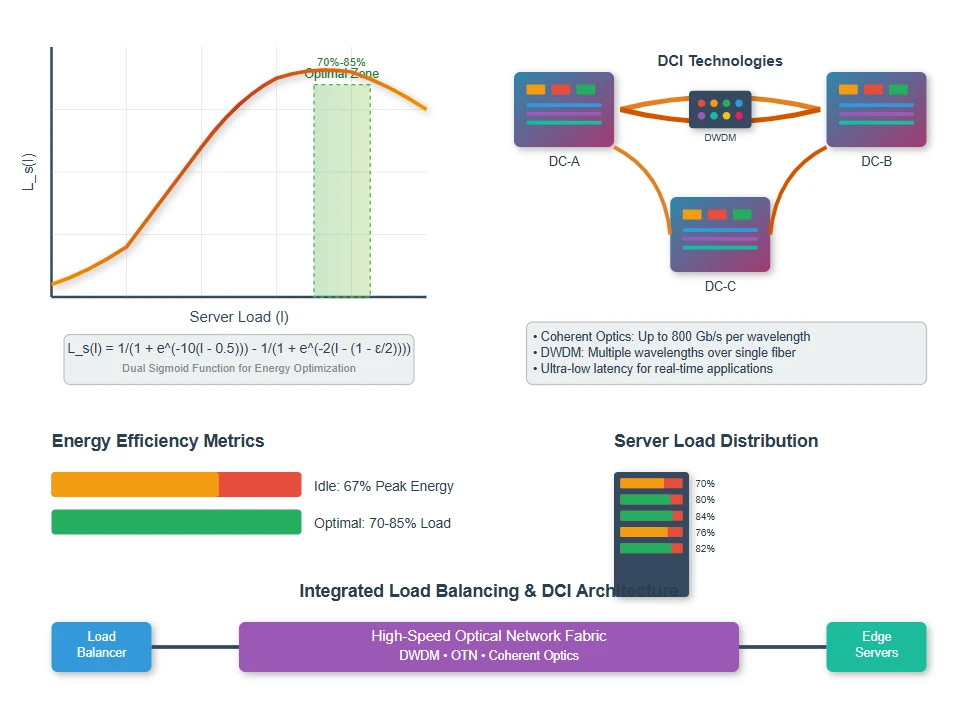
Questo approccio sofisticato garantisce che i server funzionino entro intervalli di carico ottimali, in genere tra il 70% e l'85% di utilizzo, bilanciando l'efficienza energetica con i problemi di affidabilità dell'hardware.
Metriche di gestione e congestione delle code
Analisi dell'occupazione in coda
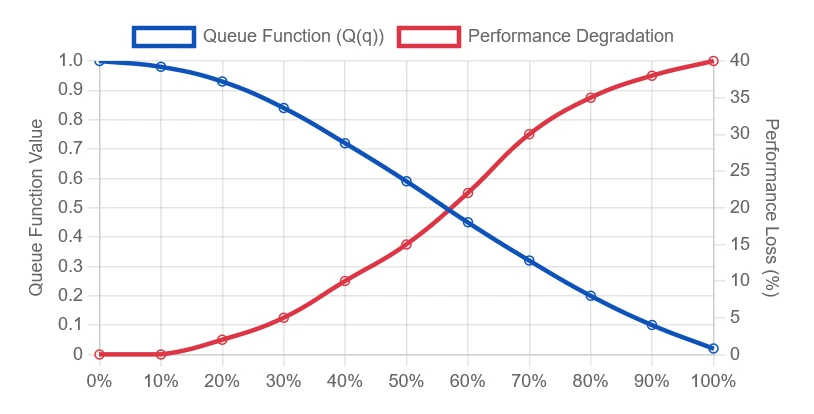
Tutti i server all'interno di un rack condividono un interruttore TOR per la comunicazione uplink. Ai tassi di gigabit, determinare la proporzione esatta della comunicazione uplink occupata da singoli server o flussi diventa intensiva computazionalmente. Per affrontare questa sfida, la metodologia delle tane incorpora un componente relativo all'occupazione della coda di output di switch Q (Q), che varia con la larghezza di banda rispetto al fattore di provisioning - Δ.
Il tasso di occupazione Q è indipendente dalla dimensione della coda assoluta ma varia con la dimensione totale della coda Q_max, che va da [0,1], dove 0 e 1 corrispondono rispettivamente agli stati di coda vuoti e completi. Introducendo il componente di occupazione della coda, la metrica delle tane può rispondere alle variazioni di congestione all'interno di rack o moduli anziché variazioni della velocità di trasmissione.
Implementazione della distribuzione di Weibull
Q (q)=e^(- (3q/q_max)^2)
Occupazione in coda vs. Performance
Metriche delle prestazioni e risultati di ottimizzazione
Bell - Funzione di selezione modellata
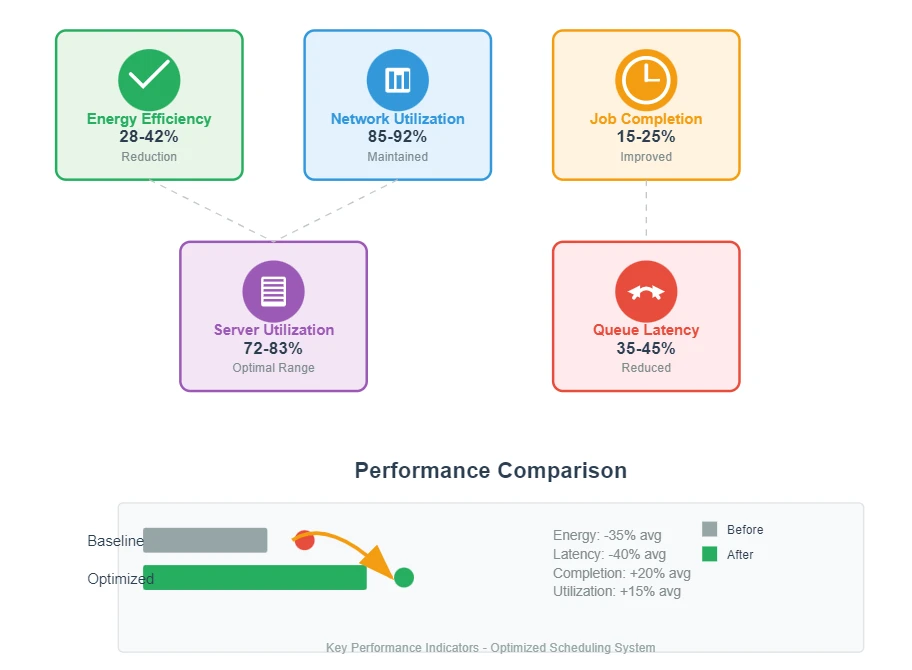
La funzione F_S (L, Q) crea una superficie a forma di campana - rispetto al carico del server L e al carico della coda Q. Questa funzione seleziona preferibilmente i server al di sopra dei livelli di carico medi situati in rack con congestione minima o nessuna. Studi empirici dimostrano che questo approccio può raggiungere un risparmio energetico di 25 - 35% rispetto alla pianificazione tradizionale round-robin mantenendo le prestazioni entro il 5% dei livelli ottimali.
Risparmio energetico
25-35%
Rispetto al round tradizionale - algoritmi di pianificazione robin
Prestazione
95%+
Mantiene le prestazioni entro il 5% dei livelli ottimali
Utilizzo
70-85%
Efficienza di bilanciamento della gamma di utilizzo del server ottimale e affidabilità
Analisi dell'impatto gerarchico
I fattori di impatto per rack e moduli sono espressi come:
Rack - Fattore di livello
Modulo - Fattore di livello
Considerazioni pratiche di implementazione
Commercio di efficienza energetica - offs
Quando si esamina cosa significa DCI per l'energia - pianificazione efficiente, diventa chiaro che le implementazioni DCI devono bilanciare attentamente l'ottimizzazione locale all'interno dei singoli data center contro l'ottimizzazione globale tra le strutture interconnesse.
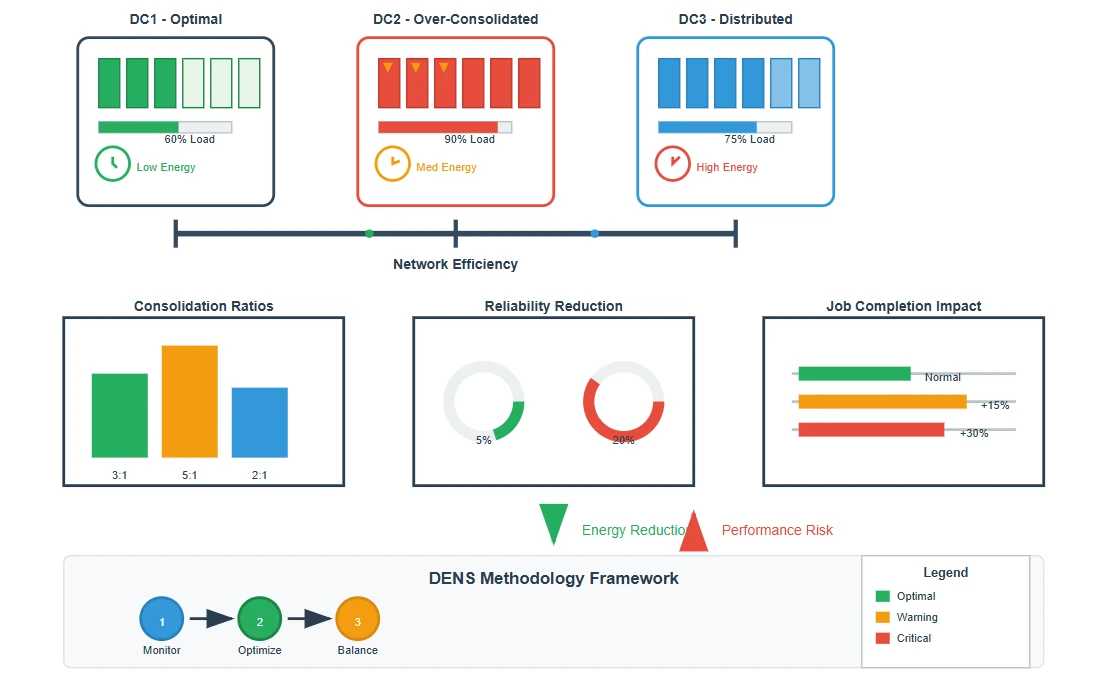
La metodologia delle tane dimostra che l'energia - gli pianificatori efficienti devono consolidare i lavori di data center all'interno del set di server più piccoli possibili, ottenendo rapporti di consolidamento di 3: 1 o superiore in scenari tipici.
Tuttavia, il funzionamento continuo ai carichi di picco può ridurre l'affidabilità hardware del 15-20% e influire sui tempi di completamento del lavoro fino al 30%.
Chiave Trade - offs
Un consolidamento più elevato riduce il consumo di energia
Il bilanciamento del carico ottimale migliora l'efficienza della rete
Over - Il consolidamento aumenta il rischio di fallimento (riduzione dell'affidabilità del 15-20%)
I carichi di picco possono influire sui tempi di completamento del lavoro fino al 30%
Multi - Bilanciamento del carico del percorso
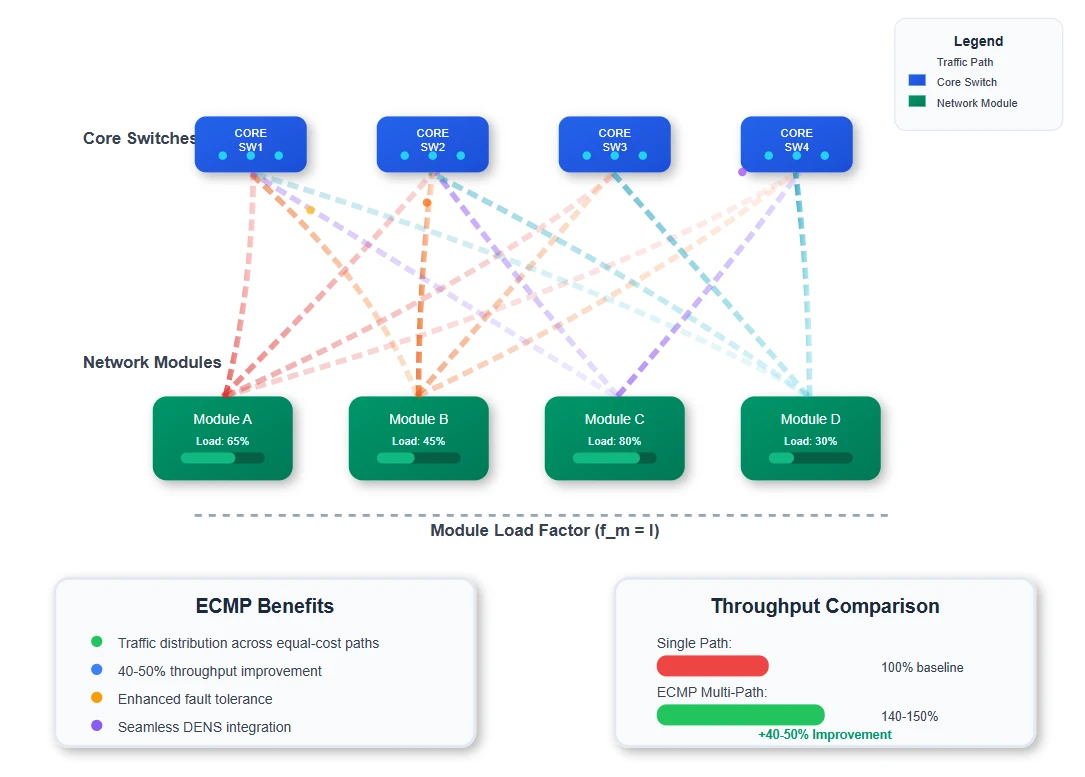
Il modulo - Fattore di livello F_M include solo un carico - componente corretto L, poiché tutti i moduli si collegano agli stessi switch core e ottengono una larghezza di banda identica tramite ECMP (uguale - COSTO Multi -) tecniche di routing. Questo design garantisce che la distribuzione del traffico rimanga bilanciata attraverso i percorsi disponibili, con miglioramenti misurati in throughput di 40 - 50% rispetto agli approcci di routing a percorso singolo.
Vantaggi di routing ECMP
Distribuisce il traffico su percorsi di costo più uguali -
Migliora il throughput di 40 - 50% vs. single-path routing
Migliora la tolleranza ai guasti attraverso la ridondanza del percorso
Funziona perfettamente con il modello gerarchico da tane
Strategie di ottimizzazione avanzate
Regolazione del peso dinamico
Ricerche recenti hanno esplorato la regolazione dinamica dei coefficienti di ponderazione e basato su caratteristiche di carico di lavoro - reali.
COMPUTE - Intensive Workloads =0.8, + =0.2
Comunicazione - intensiva =0.4, =0.3, =0.3
Servizi di personalizzazione del prodotto
"L'integrazione di fonti di energia rinnovabile con le tane algoritmi di pianificazione basate su - ha dimostrato un notevole potenziale per ridurre le impronte di carbonio nei data center iperscale."
Riduzione fino al 45% del consumo di energia della rete
Fonte: Zhang et al. (2024), Transazioni IEEE sul calcolo sostenibile
Servizio di campionamento gratuito
L'incorporazione di algoritmi di apprendimento automatico per prevedere i modelli di traffico e ottimizzare i parametri delle tane ha mostrato risultati promettenti.
Accuratezza dell'85% nella previsione della congestione
Orizzonte di previsione di 5 minuti
10-15% di risparmio energetico aggiuntivo
Convalida sperimentale e risultati
Ambiente di simulazione
Le ampie simulazioni che utilizzano simulatori di eventi discreti hanno convalidato la metodologia della tasca attraverso varie configurazioni di data center. Gli scenari di prova includevano data center che vanno da 1.000 a 100.000 server, con vari modelli di traffico tra cui servizi Web (80% di lettura, scrittura del 20%), elaborazione batch (lettura/scrittura bilanciata) e applicazioni di streaming (scrittura al 95%, lettura del 5%).
Scala del server
Da 1.000 a 100.000 server
Modelli di traffico
Servizi Web, elaborazione batch, streaming
Tipo di simulazione
Simulatori di eventi discreti
Metriche di performance
Indicatori di prestazione chiave
Confronto delle prestazioni